
Inkling 2 Mini roda offline em Macs com pelo menos 32 GB de memória

A Thinking Machines apresentou em 20 de novembro o Inkling 2 Mini, um modelo de inteligência artificial com 26,4 bilhões de parâmetros que pode funcionar offline em computadores de uso comum. A empresa afirma que Macs com Apple Silicon e pelo menos 32 GB de memória unificada conseguem executá-lo pelo Ollama.
O modelo tem cerca de 20 GB de tamanho e foi pensado para tarefas de programação, raciocínio e uso de agentes de IA. A sacada está na arquitetura: em vez de simplesmente reduzir o modelo maior da empresa, o Inkling 2 Mini repete parte das camadas para fazer mais processamento interno sem gerar tokens adicionais.
Como a arquitetura do Inkling 2 Mini amplia o processamento
Segundo o anúncio técnico da Thinking Machines, o Inkling 2 Mini usa uma arquitetura Transformer MoE, com 24 camadas. São 26,4 bilhões de parâmetros no total, dos quais 3,4 bilhões ficam ativos em cada processamento. As 12 camadas centrais são executadas três vezes, enquanto as seis primeiras e as seis últimas passam apenas uma vez.
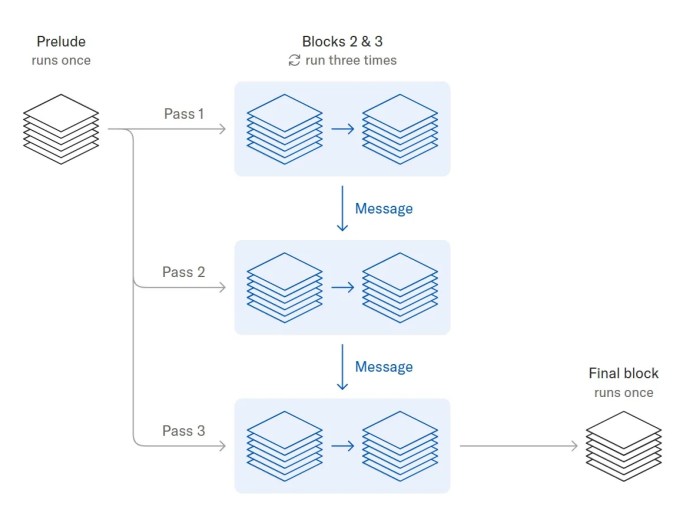
Com esse ciclo, cada token passa por 48 aplicações de camadas, embora o modelo armazene pesos para 24. A empresa calcula que isso eleva o processamento ativo efetivo para 5,4 bilhões de parâmetros por token. Na prática, o sistema consegue dedicar mais computação ao raciocínio antes de entregar a próxima parte da resposta, sem aumentar na mesma proporção a memória necessária.
A Thinking Machines divulgou resultados em quatro avaliações, mas ressalvou que diferenças nas configurações de teste impedem tratar os números como vantagem universal. Nos dois testes de programação comparados diretamente, o modelo ficou à frente do Qwen3.8-27B.
| Avaliação | Inkling 2 Mini | Comparação divulgada |
|---|---|---|
| DeepSWE v1.1 | 48,2% | Qwen3.8-27B: 42,2% |
| SWE-bench Pro v2 Hard | 77,9% | Qwen3.8-27B: 73,8% |
| Vals Index v2.2 | 46,5% | Sem comparação citada |
| SWE-bench Verified | 79,2% | Sem comparação citada |
O Inkling 2 Mini também marcou 20,1 no Intelligence Index da Artificial Analysis. Esses resultados foram divulgados pela própria Thinking Machines, então servem como referência para os testes mencionados, não como garantia de desempenho igual em qualquer computador ou tarefa.
Inkling 2 Mini roda localmente e aceita texto e imagem
Além dos Macs com ao menos 32 GB de memória unificada, o modelo tem suporte oficial ao computador de IA DGX Spark, da NVIDIA. Outras configurações com GPU também podem funcionar, mas a empresa recomenda pelo menos 32 GB de memória de vídeo. O sistema aceita entradas de texto e imagem e oferece uma janela de contexto de até um milhão de tokens.
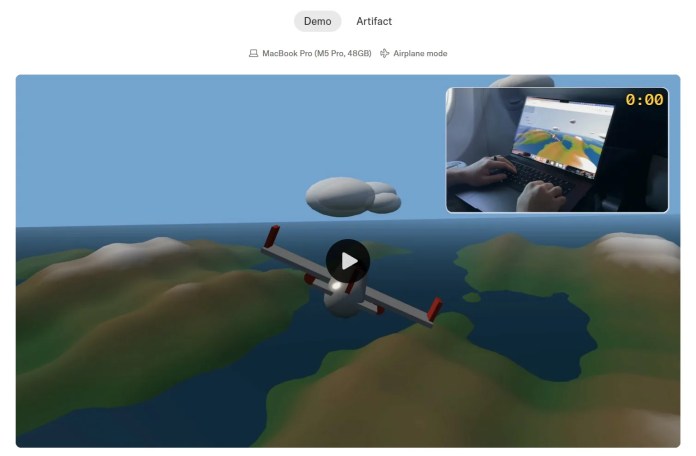
Para demonstrar o uso sem internet, a Thinking Machines mostrou o Inkling 2 Mini em um MacBook Pro com chip M5 Pro e 48 GB de memória. Durante um voo, segundo a empresa, o modelo criou em poucos minutos um simulador de voo jogável. O modelo está disponível sob a licença Apache 2.0, com pesos para baixar no Hugging Face, execução local pelo Ollama e opções de inferência e ajuste fino na plataforma Tinker.
O raciocínio interno do Inkling 2 Mini ainda tem limites
Repetir camadas também levanta uma questão de transparência: o modelo pode fazer mais computação sem registrar por escrito cada etapa do raciocínio. Para investigar esse ponto, a Thinking Machines usou um modelo de pesquisa separado, com número variável de ciclos. Nesse experimento, o horizonte de tarefas resolvidas sem uma cadeia de raciocínio explícita subiu de 16 segundos, com uma passagem, para 37 segundos, com três.

A empresa afirma que, nessa escala, o raciocínio escrito continuou compreensível e não houve redução significativa na capacidade de monitorar o modelo. Os pesquisadores também apontaram limitações: o desempenho é mais fraco em conversas complexas com várias interações e em instruções que acumulam muitas restrições. Ou seja, o funcionamento local abre espaço para testar agentes sem depender da nuvem, mas não elimina a necessidade de conferir respostas e resultados.
📲 Se você quer acompanhar modelos que rodam no próprio computador e dispensam conexão constante, siga o Canal do TS no WhatsApp.
Para quem desenvolve, o Inkling 2 Mini reúne pesos abertos, execução local e ferramentas para ajuste do modelo. A próxima medida prática será observar como os resultados divulgados pela empresa se traduzem em tarefas reais, sobretudo nas conversas longas que os próprios pesquisadores apontam como um ponto fraco.
Perguntas frequentes
O Inkling 2 Mini funciona sem internet?
Sim. A Thinking Machines demonstrou o modelo funcionando offline em um MacBook Pro.
Quanta memória é necessária para rodar o modelo localmente?
A empresa indica pelo menos 32 GB de memória unificada. O modelo ocupa cerca de 20 GB.
Onde o Inkling 2 Mini está disponível?
Os pesos podem ser baixados no Hugging Face, e a execução local é oferecida pelo Ollama. A licença é Apache 2.0.
Fonte: Wccftech

Escrito por


