Nvidia quebra o silêncio sobre specs do Vera Rubin: o que mudou e por que

Na última semana, a Nvidia atualizou as especificações da plataforma Vera Rubin com cortes na largura de banda do HBM4 e do NVLink 6, e a reação não demorou. Agora a empresa quebrou o silêncio com uma explicação direta: as specs antigas eram alvos de desenvolvimento, e as novas são o que o sistema entrega de fato em produção.
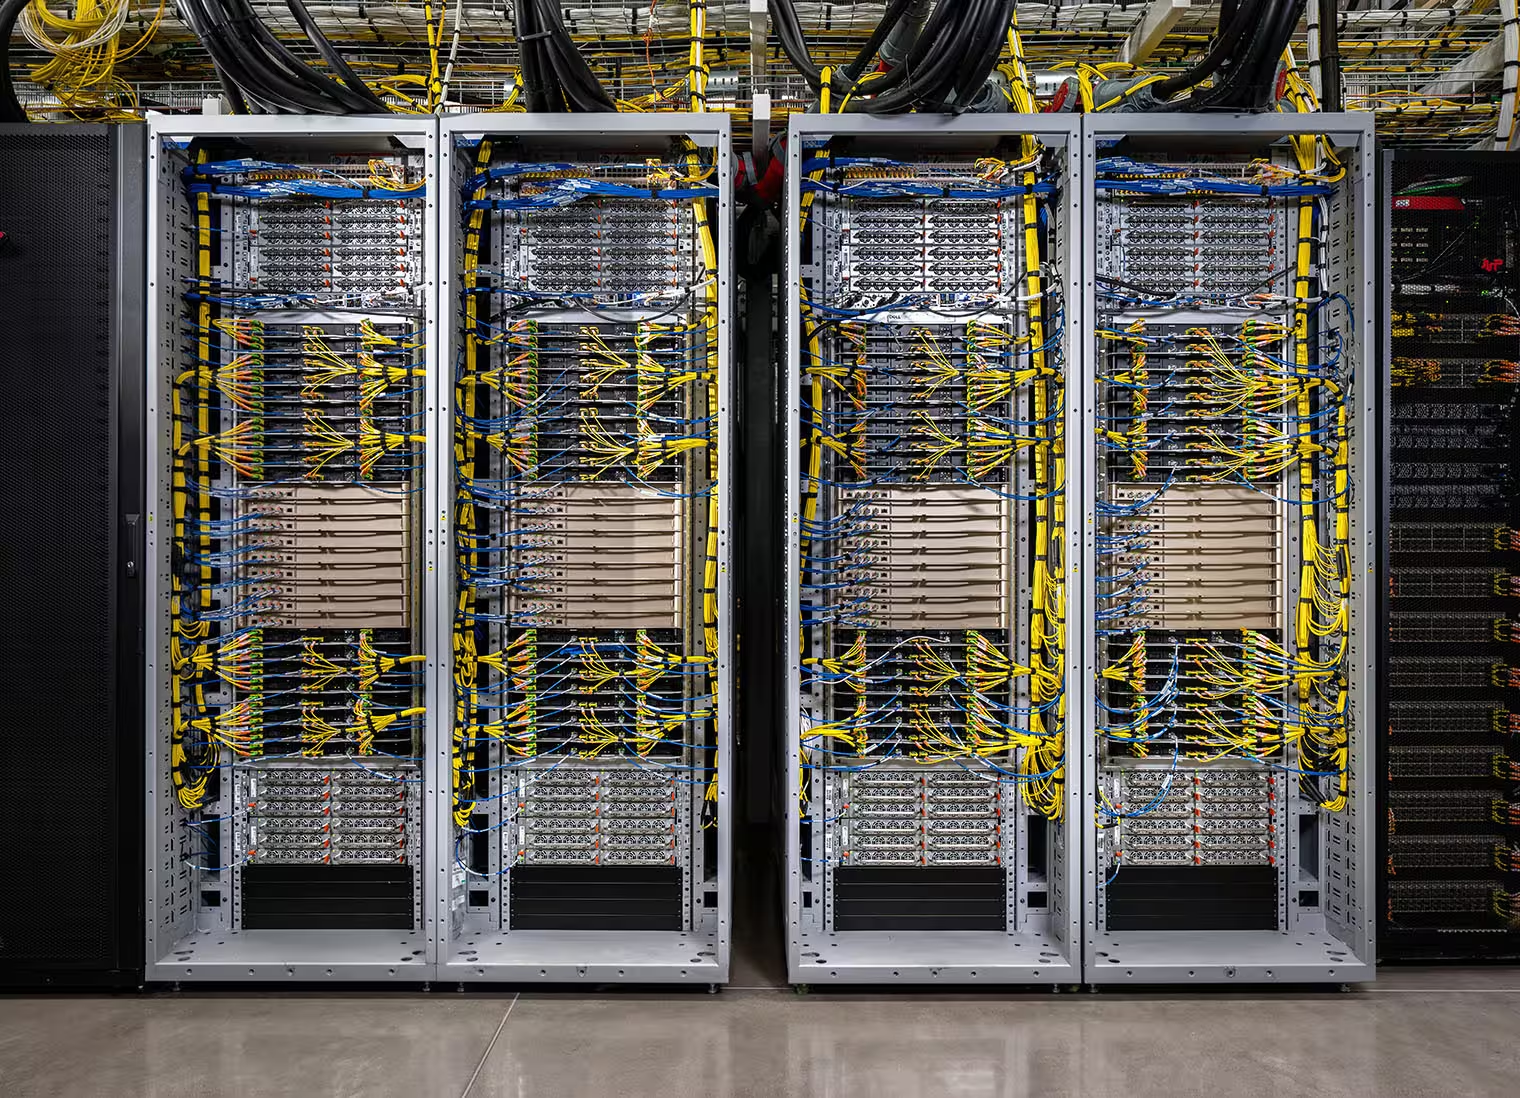
“As especificações publicadas durante o desenvolvimento do Vera Rubin eram alvos arquiteturais preliminares”, disse um representante da Nvidia ao site Wccftech. “As especificações finais em nvidia.com e na folha de dados do Vera Rubin refletem o que o sistema sustenta em produção qualificada e em volume.”
O que mudou nas especificações do Vera Rubin
A Nvidia não alterou a capacidade de HBM4 (288 GB por GPU), mas reduziu a largura de banda. No Rubin GPU individual, o HBM4 caiu de 22 TB/s para 19,2 TB/s (12,7% a menos), e o NVLink 6 foi de 3,6 TB/s para 3 TB/s (16,7% a menos). No sistema completo NVL72, a largura de banda HBM4 agregada passou de 1.580 TB/s para 1.400 TB/s, queda de 11,4%. Já o HGX Rubin NVL8 teve o maior corte proporcional: 26,1% na banda HBM4, que foi de 176 TB/s para 130 TB/s.
12,7%
Queda na largura de banda HBM4 do Rubin GPU
Fonte: Nvidia
16,7%
Queda na largura de banda NVLink 6 do Rubin GPU
Fonte: Nvidia
Do outro lado, a Nvidia aumentou a largura de banda de rede em 12,5% em todas as configurações, subiu de 0,8 TB/s para 0,9 TB/s no superchip, e de 28,8 TB/s para 32,4 TB/s no NVL72. O desempenho de treinamento também sofreu ajustes marginais: NVFP4 caiu de 280 para 270 PFLOPS (3,6%), e FP8/FP6 foi de 140 para 130 PFLOPS (7,1%).
Benchmarks de terceiros já usavam as specs finais
A Nvidia fez questão de ressaltar que os benchmarks independentes publicados até agora para o Vera Rubin foram medidos com as especificações de produção, as mesmas que estão em produção em volume hoje. Ou seja, nenhum resultado precisa ser revisado.

“Benchmarks de agentes de IA de terceiros estão disponíveis há meses com desempenho excepcional medido usando especificações de produção, 30x mais desempenho por watt e 30x mais tokens por dólar em comparação com a geração anterior GB300 NVL72”, afirmou o representante. A empresa sugere que quem quiser comparar plataformas confira os resultados do AgentX com SemiAnalysis e do AgentPerf com Artificial Analysis.
Vera Rubin está em produção e entregando
A Nvidia também confirmou que o Vera Rubin NVL72 está em produção plena e sendo enviado para clientes desde a última semana, como adiantou a imprensa especializada. A empresa diz que o sistema foi “projetado para agentes de IA”, workloads que raciocinam, chamam ferramentas, recuperam e avaliam informações milhares de vezes por tarefa. Nesse tipo de operação, o desempenho é decidido em escala de datacenter, não por um componente isolado.
“Os ganhos vêm do co-design extremo entre modelos, software, computação, rede e memória”, disse a Nvidia. “É por isso que publicamos desempenho Pareto em modelos nomeados e configurações reais de agentes.”
📲 A corrida pela infraestrutura de IA não para. Para acompanhar cada movimento da Nvidia e dos gigantes do setor, entra no Canal do TS no WhatsApp.
Fonte: Wccftech

Escrito por


